Domain einzelelement.de kaufen?
Wir ziehen mit dem Projekt
einzelelement.de um.
Sind Sie am Kauf der Domain
einzelelement.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain einzelelement.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Brinkmann, Ulrich: Obacht an der Wäschespinne! Die Siedlung als Element des StädtebausObacht an der Wäschespinne! Die Siedlung als Element des Städtebaus , Die Siedlungen und Großsiedlungen der Nachkriegszeit haben, im Osten ebenso wie im Westen Deutschlands, einen schlechten Ruf: Ihre standardisierten Lebenswelten passen nicht zu heutigen Vorstellungen, und ihre ursprünglichen Qualitäten lassen sich nach Jahrzehnten der Sanierung oft nur noch erahnen. In dem vorliegenden Buch plädiert der Architekt und Journalist Ulrich Brinkmann für einen neuen, von derzeitigen Klischees unverstellten Blick auf diese Areale der Stadt. Wie in den Vorgängerbänden zu Fußgängerzonen (Achtung vor dem Blumenkübel!) und Straßen (Vorsicht auf dem Wendehammer!) nähert sich Brinkmann seinem Thema, indem er Ansichtspostkarten der Fünfziger- bis Achtzigerjahre analysiert. Die Karten sind Ausgangspunkt für Überlegungen zu den Gestaltqualitäten der Nachkriegsmoderne, Anknüpfungspunkte für Identifikation, Wertschätzung und Weiterentwicklung. Was fehlt den Siedlungen, um Ort zu sein? Vor allem aber: Ist seit dem Erstbezug dort irgendetwas entstanden, das dazu beitragen könnte, dies zu verändern? , Tagfahrlichter > Lichter & Leuchten , Erscheinungsjahr: 20231210, Titel der Reihe: Grundlagen / Basics#172#, Autoren: Brinkmann, Ulrich, Seitenzahl/Blattzahl: 256, Keyword: Architektur; BRD; DDR; Philokartie; Postkarten; Siedlungsbau, Fachschema: Haus / Wohnhaus~Wohnhaus~Architektur / Geschichte, Regionen, Fachkategorie: Geschichte der Architektur, Warengruppe: HC/Architektur, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 231, Breite: 208, Höhe: 17, Gewicht: 848, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik,28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
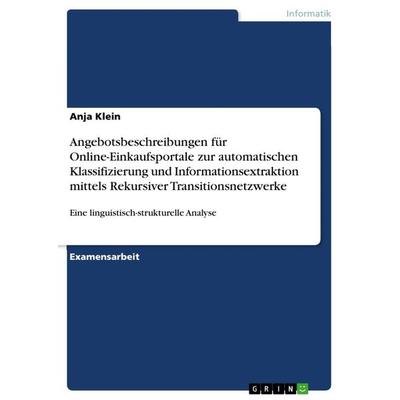
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Brinkmann, Ulrich: Obacht an der Wäschespinne! Die Siedlung als Element des StädtebausObacht an der Wäschespinne! Die Siedlung als Element des Städtebaus , Die Siedlungen und Großsiedlungen der Nachkriegszeit haben, im Osten ebenso wie im Westen Deutschlands, einen schlechten Ruf: Ihre standardisierten Lebenswelten passen nicht zu heutigen Vorstellungen, und ihre ursprünglichen Qualitäten lassen sich nach Jahrzehnten der Sanierung oft nur noch erahnen. In dem vorliegenden Buch plädiert der Architekt und Journalist Ulrich Brinkmann für einen neuen, von derzeitigen Klischees unverstellten Blick auf diese Areale der Stadt. Wie in den Vorgängerbänden zu Fußgängerzonen (Achtung vor dem Blumenkübel!) und Straßen (Vorsicht auf dem Wendehammer!) nähert sich Brinkmann seinem Thema, indem er Ansichtspostkarten der Fünfziger- bis Achtzigerjahre analysiert. Die Karten sind Ausgangspunkt für Überlegungen zu den Gestaltqualitäten der Nachkriegsmoderne, Anknüpfungspunkte für Identifikation, Wertschätzung und Weiterentwicklung. Was fehlt den Siedlungen, um Ort zu sein? Vor allem aber: Ist seit dem Erstbezug dort irgendetwas entstanden, das dazu beitragen könnte, dies zu verändern? , Tagfahrlichter > Lichter & Leuchten , Erscheinungsjahr: 20231210, Titel der Reihe: Grundlagen / Basics#172#, Autoren: Brinkmann, Ulrich, Seitenzahl/Blattzahl: 256, Keyword: Architektur; BRD; DDR; Philokartie; Postkarten; Siedlungsbau, Fachschema: Haus / Wohnhaus~Wohnhaus~Architektur / Geschichte, Regionen, Fachkategorie: Geschichte der Architektur, Warengruppe: HC/Architektur, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 231, Breite: 208, Höhe: 17, Gewicht: 848, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik,28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
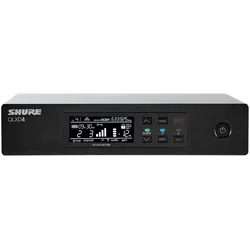
Shure QLXD4E H51 - EinzelkomponenteDer QLXD4 ist der Empfänger des digitalen QLX-D Drahtlossystems; das professionelle Funktionalität mit einfacher Installation und Bedienung vereint. Automatic Channel Scan findet schnell die saubersten Frequenzen; während der Networked Channel Scan diese offenen Frequenzen zwischen mehreren Empfängern über Ethernet mit der einfachen Ein-Tasten-Synchronisation aufteilt. Die Predictive Diversity stellt eine stabile HF-Funkverbindung sicher. Die Nutzung des HF-Spektrums ist sehr effizient: bis zu 22 Sender können pro 8-MHz Kanal gleichzeitig genutzt werden. Die abhörsichere AES 256-Bit Verschlüsselung garantiert Funkübertragungen mit höchster Sicherheit und Datenschutz. Der QLX-D Receiver kann über PC-und Mac-Computer über die Shure Wireless Workbench® Software oder die iOS App ShurePlusTM Channels ferngesteuert werden. Für die einfache Installation in professionellen Umgebungen ist der Empfänger im 9;5“-Rackformat mit abnehmbaren Halbwellenantennen ausgeführt.Automatic Channel Scan zum sc875,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.